Maintenance application : quatre signaux qui révèlent une dette technique coûteuse
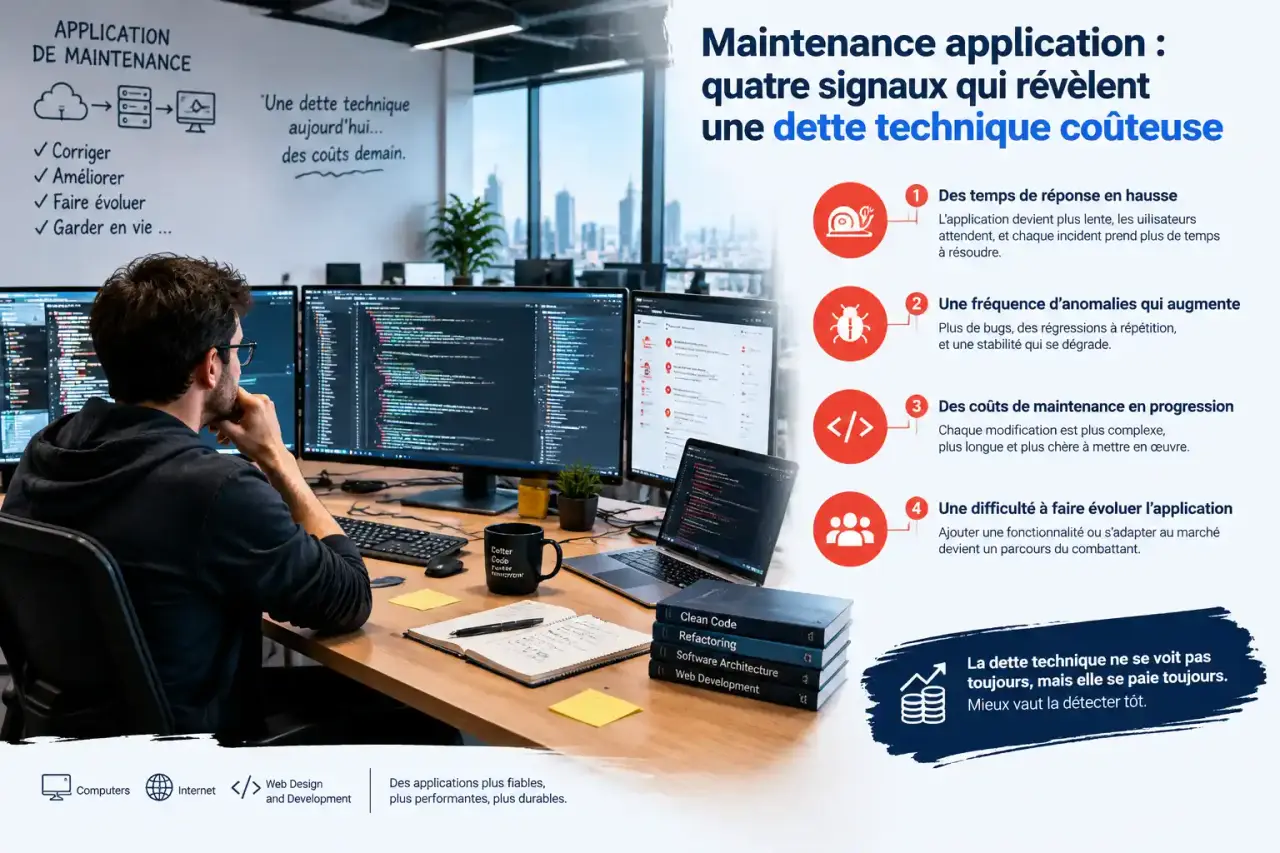
Une application ne devient pas fragile du jour au lendemain. Les incidents visibles, comme les lenteurs, les erreurs, les indisponibilités ou les failles, sont souvent précédés de signaux plus discrets : dépendances vieillissantes, alertes ignorées, déploiements difficiles ou demandes utilisateurs qui s’accumulent. La maintenance application consiste à surveiller, corriger et faire évoluer le logiciel avant que ces symptômes ne perturbent l’activité.
Comprendre ce que couvre réellement la maintenance application
La maintenance ne consiste pas uniquement à intervenir lorsqu’un écran affiche une erreur. Elle accompagne l’application après sa mise en production et couvre la continuité de service, la sécurité, la performance, la compatibilité ainsi que l’adaptation aux besoins métier. Cette activité régulière doit être priorisée et pilotée au même titre que le développement de nouvelles fonctionnalités.
Les quatre formes de maintenance à combiner
- La maintenance corrective résout un défaut constaté : calcul erroné, page inaccessible, synchronisation incomplète ou bug sur un navigateur précis.
- La maintenance préventive réduit le risque d’incident grâce à la mise à jour d’un composant, à la suppression de code obsolète, à l’amélioration des sauvegardes ou au renforcement des tests.
- La maintenance évolutive adapte l’application à un nouveau besoin, à une réglementation, à un changement de processus ou à une intégration avec un autre outil.
- La maintenance adaptative garantit la compatibilité avec l’environnement technique : système d’exploitation, navigateur, API tierce, infrastructure cloud ou version de base de données.
Ces catégories se recoupent parfois. Une mise à jour de framework peut être préventive, mais aussi adaptative si elle devient indispensable pour rester compatible avec l’hébergement. L’essentiel est de qualifier chaque demande pour évaluer son urgence, son impact et le niveau de risque associé.
Repérer les signaux avant qu’ils ne bloquent les utilisateurs
Une stratégie de maintenance application commence par l’observation. Attendre une panne majeure conduit souvent à traiter le problème dans l’urgence, avec moins de temps pour tester la correction et davantage de conséquences pour les équipes.
Quatre alertes à ne pas banaliser
- Les corrections sont de plus en plus lentes. Si un bug mineur exige plusieurs jours d’analyse, la connaissance du code, la documentation ou les tests automatisés sont probablement insuffisants. Le délai révèle souvent une difficulté à comprendre l’application plutôt que la complexité réelle du défaut.
- Les déploiements deviennent anxiogènes. Des mises en production manuelles, longues ou difficiles à annuler indiquent que la chaîne de livraison doit être fiabilisée. Chaque intervention augmente alors le risque d’erreur et mobilise davantage de personnes.
- Les performances se dégradent sans évolution majeure. Une hausse des temps de réponse, des requêtes lentes ou une consommation inhabituelle de ressources doit être analysée avant d’affecter l’expérience utilisateur. Une dégradation progressive peut rester invisible jusqu’à ce qu’elle gêne un processus métier.
- Les dépendances ne sont plus maintenues. Une bibliothèque, un système ou une API arrivée en fin de support expose l’application à des incompatibilités et à des vulnérabilités. Le remplacement demande souvent plus de temps lorsqu’il est repoussé jusqu’à l’apparition d’un incident.
Il existe un écart entre une application qui « fonctionne encore » et une application réellement maîtrisée. Le premier état peut masquer des tâches manuelles, des exceptions connues par une seule personne ou des erreurs que les utilisateurs ont appris à contourner. Cartographier ces contournements est utile : ils révèlent les zones où la dette technique devient une dette opérationnelle, avec des ressaisies, des retards et une qualité de données dégradée.
Faire remonter les incidents de façon exploitable
Un ticket utile ne se limite pas à la mention « cela ne marche pas ». Il précise le parcours concerné, le résultat attendu, le résultat observé, l’heure, le compte utilisé, l’appareil ou le navigateur et, si possible, une capture d’écran. Ces informations réduisent les échanges inutiles et permettent à l’équipe technique de reproduire le défaut.
Il faut aussi distinguer l’incident isolé de la dégradation généralisée. Un problème limité à un compte, un navigateur ou une action précise ne se traite pas comme une indisponibilité qui touche l’ensemble des utilisateurs. Cette distinction aide à choisir le bon niveau de priorité et à éviter les corrections provisoires mal ciblées.
Organiser les priorités entre urgence, sécurité et évolution
Tout ne peut pas être corrigé immédiatement. La difficulté consiste à ne pas laisser les demandes les plus visibles écarter systématiquement les travaux qui protègent l’application à moyen terme. Un backlog de maintenance clair rend les arbitrages plus cohérents et permet de suivre les sujets reportés.
| Critère | Question à poser | Conséquence sur la priorité |
|---|---|---|
| Impact métier | Combien d’utilisateurs ou de processus sont touchés ? | Un blocage de transaction ou d’accès passe avant un défaut cosmétique. |
| Sécurité | Existe-t-il un risque d’accès non autorisé, de fuite ou de corruption ? | Le correctif doit être traité sans attendre le cycle habituel. |
| Probabilité | Le problème est-il reproductible ou susceptible de se généraliser ? | Un défaut fréquent mérite une action durable, pas un simple contournement. |
| Coût du report | Que se passe-t-il si l’on attend un mois ou un trimestre ? | Une dépendance en fin de support ou une migration annoncée doit être anticipée. |
Cette grille peut être utilisée lors d’un point de pilotage régulier avec les responsables métier et techniques. Elle évite deux écueils : transformer toute demande en urgence ou repousser sans cesse les sujets moins visibles, comme les sauvegardes, la journalisation et la mise à jour des composants.
Le suivi des sujets reportés est tout aussi important que leur classement initial. Une demande repoussée sans date, responsable ou condition de réexamen finit par disparaître du radar. À l’inverse, un élément documenté peut être réévalué lorsque le contexte change, qu’une dépendance approche de sa fin de support ou que son impact métier augmente.
Définir un niveau de service réaliste
Pour chaque type d’incident, il est utile de fixer un délai de prise en charge et un objectif de résolution. Une indisponibilité complète, une erreur bloquante sur une fonctionnalité centrale et une anomalie d’affichage ne peuvent pas être traitées avec le même engagement.
Ces règles doivent aussi préciser les horaires de couverture, le canal de signalement et les personnes habilitées à valider un correctif en production. Une organisation claire limite les hésitations lorsque l’incident survient et évite de solliciter les mêmes interlocuteurs pour chaque demande, quel que soit son niveau de gravité.
Mettre en place un cycle de maintenance fiable
La régularité est plus efficace qu’une grande opération de nettoyage menée trop tard. Un cycle simple, documenté et mesurable sécurise les interventions tout en préservant la capacité à faire évoluer le produit. Il permet aussi de répartir les travaux au lieu de concentrer la maintenance sur quelques périodes de crise.
Du diagnostic au retour d’expérience
Chaque intervention importante gagne à suivre une séquence stable : qualification du besoin, analyse de la cause, estimation, correction dans un environnement contrôlé, tests, déploiement, surveillance puis documentation. Cette méthode donne à chacun une vision claire de l’avancement et réduit le risque d’oublier une étape avant la mise en production.
En cas d’incident, le retour d’expérience ne cherche pas un responsable. Il identifie ce qui a permis au défaut d’arriver en production et ce qui aurait permis de le détecter plus tôt. L’analyse peut conduire à ajouter un test, une alerte, une règle de revue de code ou une procédure de restauration. La correction porte ainsi sur la cause et sur le dispositif qui doit éviter une répétition.
Les indicateurs qui aident à décider
Quelques indicateurs suffisent pour suivre la santé de l’application : nombre d’incidents par période, délai moyen de prise en charge, délai de résolution, volume de demandes réouvertes, taux d’échec des déploiements et liste des composants à mettre à jour. Ils doivent être interprétés avec le contexte métier.
Une baisse des tickets peut traduire une amélioration, mais aussi des utilisateurs qui ne savent plus à qui signaler un problème. De la même manière, une hausse temporaire des incidents peut résulter d’une meilleure détection plutôt que d’une dégradation réelle. Les indicateurs servent donc à orienter les décisions, pas à remplacer l’analyse des situations.
Enfin, la documentation doit rester un livrable de maintenance, et non une tâche reportée indéfiniment. Architecture, procédures de déploiement, accès, dépendances, sauvegardes et règles métier critiques doivent pouvoir être compris sans dépendre d’une seule personne. Cette continuité des connaissances permet de corriger plus vite, d’intégrer de nouveaux intervenants et de faire durer l’application sans multiplier les risques.