 Graph
Infogérance OVH : une supervision 24/7 ne suffit pas à protéger vos services
L’infogérance OVH consiste à déléguer l’exploitation de votre infrastructure OVHcloud à un prestataire spécialisé : surveillance, maintenance, sécurité, sauvegardes et traitement des incidents. Pour choisir une offre, vérifiez surtout qui intervient, sur quel périmètre et avec quels engagements. Une alerte reçue la nuit ne rétablit pas, à elle seule, une application indisponible.
Définir les responsabilités avant de comparer les offres
OVHcloud fournit des services d’infrastructure dont le périmètre varie selon le produit souscrit. Sur un serveur non managé, la disponibilité du matériel ne signifie pas que le système Linux, la base de données ou votre application sont administrés. L’infogéreur prend en charge tout ou partie de cette exploitation, conformément au contrat.
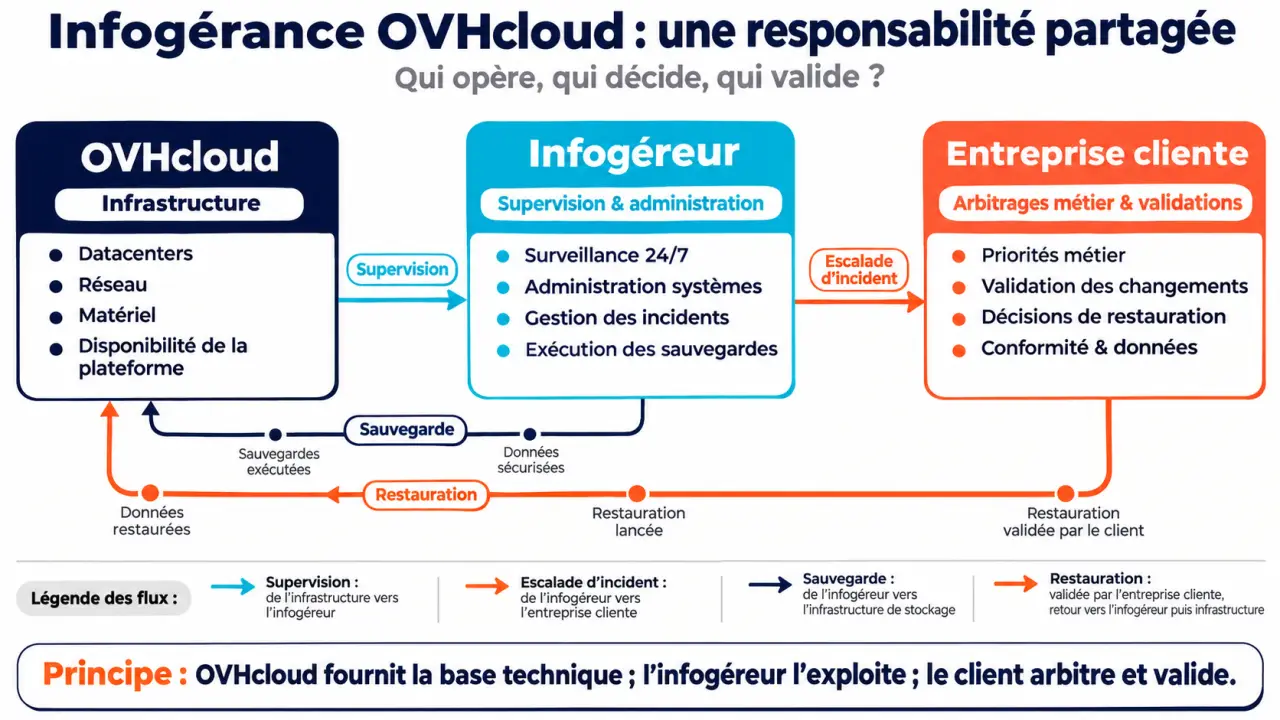
Le support du fournisseur et l’infogérance sont donc complémentaires. Lorsqu’un incident relève du matériel ou du réseau du fournisseur, le prestataire peut assurer le diagnostic et l’escalade auprès d’OVHcloud. Lorsqu’il concerne un disque logique saturé, un service arrêté ou une configuration système, son intervention dépend du périmètre convenu.
- OVHcloud : responsabilités liées aux services d’infrastructure souscrits.
- L’infogéreur : administration, surveillance et interventions expressément incluses.
- Votre entreprise : arbitrages métier, validation des changements et responsabilités non déléguées, notamment applicatives.
La gestion interne reste pertinente si votre équipe possède les compétences, les procédures et la disponibilité nécessaires. Une infogérance partielle peut compléter cette équipe ; une prise en charge plus large convient lorsque personne ne peut assurer durablement l’exploitation. Dans les deux cas, conservez un responsable interne capable de décider et de suivre le prestataire.
Exiger une chaîne complète, de la détection à la restauration
Superviser des services, pas seulement des machines
Une supervision 24/7 doit surveiller les ressources système, mais aussi les services utiles : réponse du site, état de la base de données, certificats et exécution des sauvegardes. Demandez ce qui déclenche une alerte, qui la reçoit et quelles actions suivent. La surveillance continue n’implique pas automatiquement une intervention humaine permanente.
La priorité d’un incident doit refléter son impact métier. Une boutique inaccessible et une partition secondaire presque pleine n’appellent pas la même réponse. Le contrat doit distinguer délai de prise en charge, délai d’intervention et objectif de rétablissement, avec une procédure d’escalade et des modalités d’information du client.
Maintenir et sécuriser sans casser la production
La maintenance Linux comprend les mises à jour, le suivi des vulnérabilités CVE et la planification des redémarrages nécessaires. Le durcissement système, ou hardening, vise à réduire l’exposition : services inutiles désactivés, pare-feu adapté, accès SSH contrôlés et droits limités. Les changements sensibles doivent prévoir une validation et une possibilité de retour arrière.
Le suivi de capacité complète ce travail : espace disque, mémoire, charge et tendances d’utilisation permettent d’anticiper une saturation. Un rapport utile explique les risques et les actions recommandées, plutôt que d’accumuler des graphiques sans décision associée.
Vérifier que les données peuvent réellement revenir
Une sauvegarde réussie n’est pas encore une restauration réussie. Faites préciser sa fréquence, sa conservation, sa localisation, son contrôle d’intégrité et les tests de restauration. Les copies doivent être suffisamment isolées de la production pour limiter les risques communs. La redondance et la haute disponibilité ne remplacent pas une sauvegarde.
Fixez aussi la perte de données acceptable, appelée RPO, et le délai de reprise visé, appelé RTO. Ces objectifs orientent le plan de reprise d’activité : ordre de redémarrage, dépendances, ressources nécessaires et validation du service restauré.
Adapter l’infogérance à l’architecture, pas l’inverse
Le bon choix ne dépend pas seulement du trafic. Il dépend aussi de la criticité du service, de la variabilité de la charge et des compétences disponibles. Un VPS peut suffire à une application modeste ; un environnement virtualisé complexe exige une exploitation plus spécialisée.
| Environnement | Usage et intérêt | Point d’attention en infogérance |
|---|---|---|
| VPS | Site ou application aux besoins contenus | Maintenance système, ressources disponibles et restauration |
| Serveur dédié | Ressources matérielles dédiées à des charges soutenues | Capacité, coordination des incidents matériels et reprise |
| Public Cloud | Instances et services pour une architecture évolutive | Automatisation, réseau, droits et maîtrise des coûts |
| Dedicated Cloud / Hosted Private Cloud | Environnements privés de virtualisation selon l’offre | Répartition des responsabilités entre plateforme et machines virtuelles |
| Proxmox sur serveurs dédiés | Virtualisation administrée avec maîtrise de l’architecture | Hyperviseurs, cluster, stockage et sauvegardes des machines virtuelles |
Proxmox n’est pas une catégorie d’hébergement équivalente au VPS : c’est une plateforme de virtualisation. Un cluster utilisant Ceph, un système de stockage distribué, demande une expertise spécifique. Une interconnexion privée annoncée à 25 Gbps constitue une caractéristique réseau à vérifier dans l’offre concernée, pas une garantie de performance applicative ou de reprise.
Représentez votre infrastructure comme une toile de dépendances : application, base de données, DNS, certificats et services externes. Un serveur peut être sain alors que le parcours de commande est bloqué par un maillon extérieur. Cette cartographie aide à placer les contrôles au bon endroit et à rédiger un runbook, le mode opératoire qui indique quoi vérifier et dans quel ordre.
Organiser la reprise sans ajouter un risque de coupure
La reprise d’une infrastructure existante commence par un état des lieux, pas par une mise à jour générale. Le prestataire doit identifier les versions, les accès, les flux réseau, les tâches planifiées et les dépendances applicatives. Il doit également signaler les composants obsolètes et les zones qu’il ne peut pas encore prendre en charge.
- Inventorier : serveurs, applications, données, contrats et contacts techniques.
- Sécuriser les accès : comptes nominatifs, droits nécessaires et traçabilité.
- Vérifier les sauvegardes : contrôler les copies et tester une restauration adaptée.
- Installer la supervision : valider les alertes et leur circuit de traitement.
- Corriger progressivement : prioriser les risques et convenir des fenêtres de maintenance.
- Documenter : produire les procédures d’exploitation et les consignes d’escalade.
Si une migration est nécessaire, exigez un plan de bascule avec tests, synchronisation des données, interruption prévue et retour arrière. La réception doit porter sur le fonctionnement réel des services, pas uniquement sur le démarrage des serveurs.
Choisir un prestataire sur des engagements vérifiables
Demandez des exemples d’environnements comparables, les compétences disponibles et un modèle de compte rendu. Un statut de partenaire OVHcloud peut être vérifié, mais ne remplace ni l’expertise sur votre architecture ni les engagements contractuels. Examinez les horaires du support, l’astreinte, les exclusions et la gestion des interventions exceptionnelles.
Pour comparer les devis, séparez reprise initiale, forfait récurrent et prestations hors forfait. Faites chiffrer les sauvegardes, les tests, les migrations et les interventions hors horaires lorsqu’ils ne sont pas inclus. Un tarif isolé ne permet pas de comparer deux périmètres différents.
Vérifiez aussi la localisation de la production et des sauvegardes. Un hébergement en France, notamment à Gravelines, Roubaix ou Strasbourg selon l’offre choisie, ne suffit pas à établir la conformité RGPD. Les accès, les sous-traitants, les engagements de traitement et la réversibilité doivent être examinés.
Pour demander un pré-audit, préparez votre inventaire, vos incidents récurrents et vos exigences de disponibilité. Attendez en retour un périmètre écrit, des risques priorisés et un plan de prise en charge. Enfin, prévoyez dès la signature la restitution des accès, des configurations et de la documentation : déléguer l’exploitation ne doit pas signifier perdre la maîtrise de votre infrastructure.